哈希表
哈希表(Hash Table),也叫散列表,是一种通过键(Key)直接访问值(Value)的高效数据结构。
它在平均情况下只需接近 O(1) 的时间复杂度,就能完成数据的插入、删除和查找。
相比之下,数组按值查找是 O(n),平衡二叉搜索树是 O(log n),数据量越大,哈希表的优势越明显。
| 操作 | 数组/链表 | 哈希表(平均) |
|---|---|---|
| 按值查找 | O(n) | O(1) |
| 插入(含定位) | O(n) | O(1) |
| 删除(含定位) | O(n) | O(1) |
| 空间利用率 | 高 | 中等 |
表中的
O(1)是平均情况。当哈希冲突非常严重时,单次操作最坏会退化到
O(n),后文的"负载因子"一节会解释如何避免这种情况。
哈希表就像一个智能的储物柜系统。
传统储物柜没有索引,你必须记住每个物品放在哪个柜子里,找东西只能一个柜子一个柜子翻。
智能储物柜则不同:你把物品名称告诉管理员,他直接报出柜子编号,你走到对应位置就能取到物品。
生活中还有不少类似的场景:
| 生活场景 | 体现的哈希思想 |
|---|---|
| 字典查词 | 根据单词首字母快速定位到页码 |
| 电话簿 | 按姓氏拼音排序,快速找到联系人 |
| 图书馆索书号 | 根据分类号直接定位到书架位置 |
想象一座藏书上万的图书馆,你想找《哈利·波特》。
最笨的办法是从第一个书架的第一本开始,一本一本翻过去,可能要找上几个小时。
聪明的图书管理员会使用索引系统:按书名或作者的某种规则(比如首字母)先定位到大区域,再在小范围内查找。
这个索引系统的思想,正是哈希表的核心。
基本概念
在学习实现之前,先弄清哈希表的组成和工作流程。
什么是哈希表?
哈希表是一种通过键(Key)来直接访问值(Value)的数据结构。
它利用一个叫做哈希函数的转换规则,把任意大小的键(字符串、数字或对象)转换成一个固定范围内的数字,这个数字被称为哈希值。
哈希值再作为底层数组的索引,值就存储在索引对应的数组位置上。
这就像给每个键分配一个唯一的座位号:想找数据时,用同样的规则再算一次座位号,直接走过去就能拿到,而不用挨个座位去问。
核心组件
一个哈希表主要由三个部分组成,以电话簿为例:
| 组成部分 | 作用 | 电话簿中的对应 |
|---|---|---|
| 键(Key) | 存储和查找数据时使用的标识符 | 人名 |
| 值(Value) | 与键相关联的实际数据 | 电话号码 |
| 哈希函数(Hash Function) | 把键映射为数组索引,是哈希表的心脏 | 按姓氏拼音排页的规则 |
工作原理图解
假设我们要创建一个电话簿,将人名映射到电话号码。
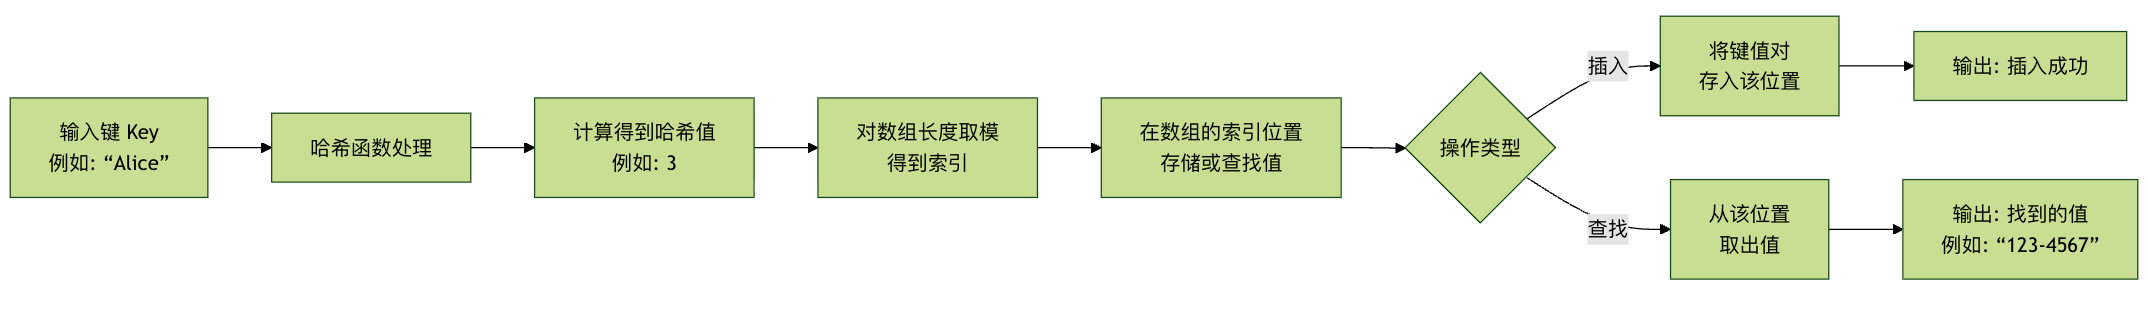
上图展示了哈希表的工作流程:无论是插入还是查找,都始于一个键。
键先经过哈希函数计算出索引,然后直接对数组的该位置进行操作,从而实现高速访问。
哈希函数
哈希函数是哈希表高效的关键,它的设计直接决定了冲突的频率。
好的哈希函数特性
评价一个哈希函数的好坏,主要看以下几个特性:
| 特性 | 描述 | 优先级 |
|---|---|---|
| 确定性 | 相同输入总是产生相同输出 | 必需 |
| 均匀分布 | 输出均匀分布在哈希表范围内 | 必需 |
| 高效计算 | 计算过程简单快速 | 重要 |
| 雪崩效应 | 输入微小变化导致输出巨大变化 | 建议 |
常见哈希函数
针对不同类型的键,有多种经典的哈希函数构造方法:
| 类型 | 示例 | 适用场景 |
|---|---|---|
| 除法取余法 | hash = key % table_size |
整数键 |
| 乘法取整法 | hash = floor(key * A % 1 * table_size) |
浮点数键 |
| 数字分析法 | 分析数字的分布规律 | 特定模式数据 |
| 平方取中法 | hash = (key * key) // 10^(n/2) % table_size |
数字键 |
| 字符串哈希 | 逐字符处理 | 字符串键 |
一个简单的哈希函数示例
假设键是字符串,数组长度是 10。
一个简单的做法是:把字符串中每个字符的 ASCII 码相加,再对数组长度取余数。
实例
"""
一个简单的字符串哈希函数。
:param key: 输入的键(字符串)
:param array_size: 哈希表数组的大小
:return: 计算得到的数组索引
"""
total = 0
for char in key:
# 将字符转换为其 ASCII 码值并累加
total += ord(char)
# 对数组大小取模,确保索引落在数组范围内
return total % array_size
# 测试我们的哈希函数
# 注意 "runoob" 与 "RUNOOB" 大小写不同,哈希值也不同
keys_to_test = ["runoob", "RUNOOB", "Alice", "David"]
array_size = 10
print("简单哈希函数测试结果:")
for key in keys_to_test:
hash_index = simple_hash(key, array_size)
print(f" 键 '{key}' -> 哈希索引: {hash_index}")
输出结果:
简单哈希函数测试结果:
  键 'runoob' -> 哈希索引: 1
  键 'RUNOOB' -> 哈希索引: 9
  键 'Alice' -> 哈希索引: 8
  键 'David' -> 哈希索引: 8
可以看到,大小写不同的 runoob 和 RUNOOB 得到了完全不同的索引,体现了哈希函数的雪崩效应。
但 Alice 和 David 的索引都是 8,两个不同的键映射到了同一个位置。
这就是下一节要解决的问题——哈希冲突。
哈希冲突与解决方法
哈希冲突是指两个或更多不同的键,经过哈希函数计算后得到了相同的数组索引。
就像电影院把同一个座位号卖给了两位观众,显然需要一套规则来处理。
冲突不可避免:哈希值的范围(数组大小)是有限的,而可能的键是无限的。
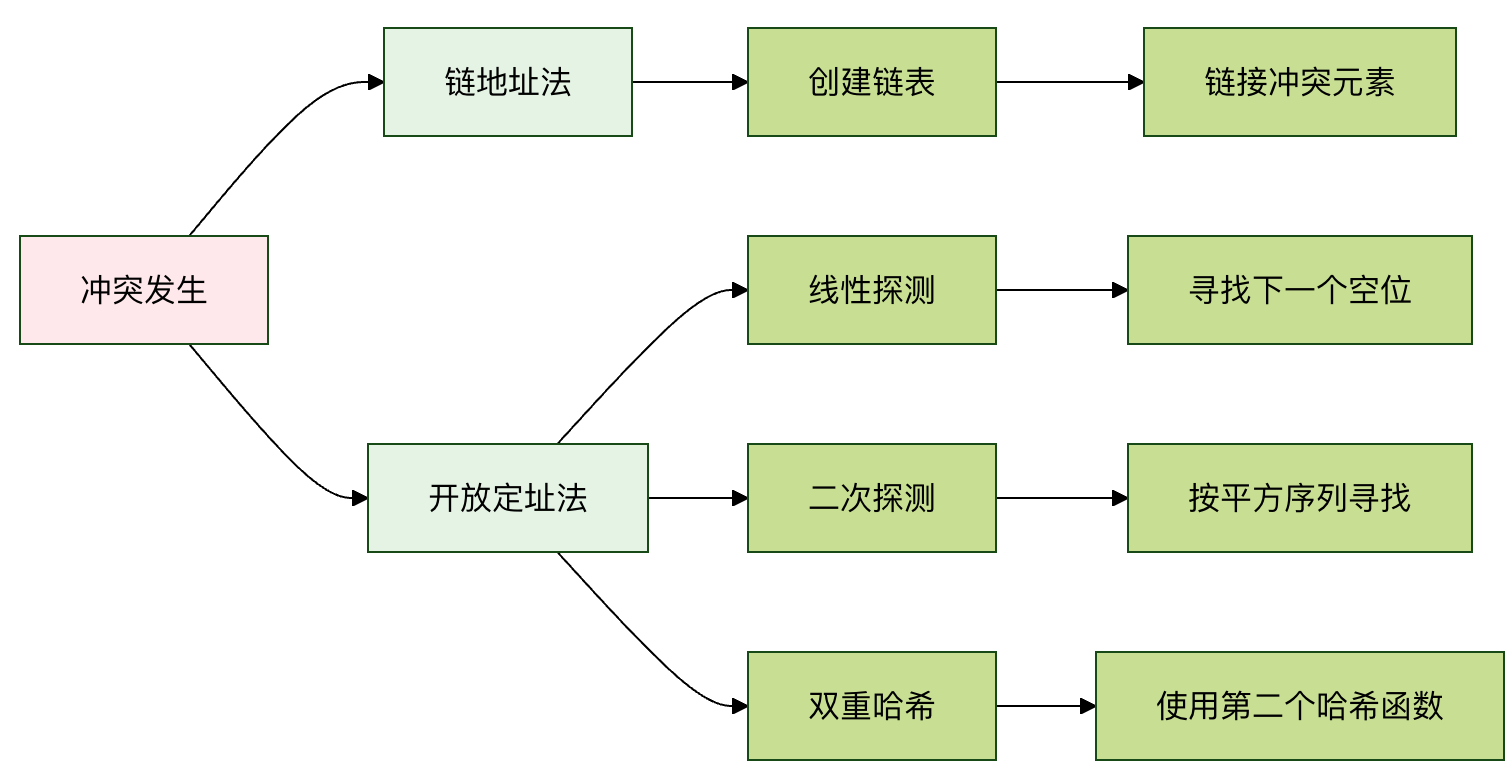
解决冲突主要有两种经典方法。
链地址法
这是最常用的方法。数组每个位置不再直接存数据,而是存放一个链表(Python 中用列表模拟),冲突的键值对依次挂在同一个链表上。
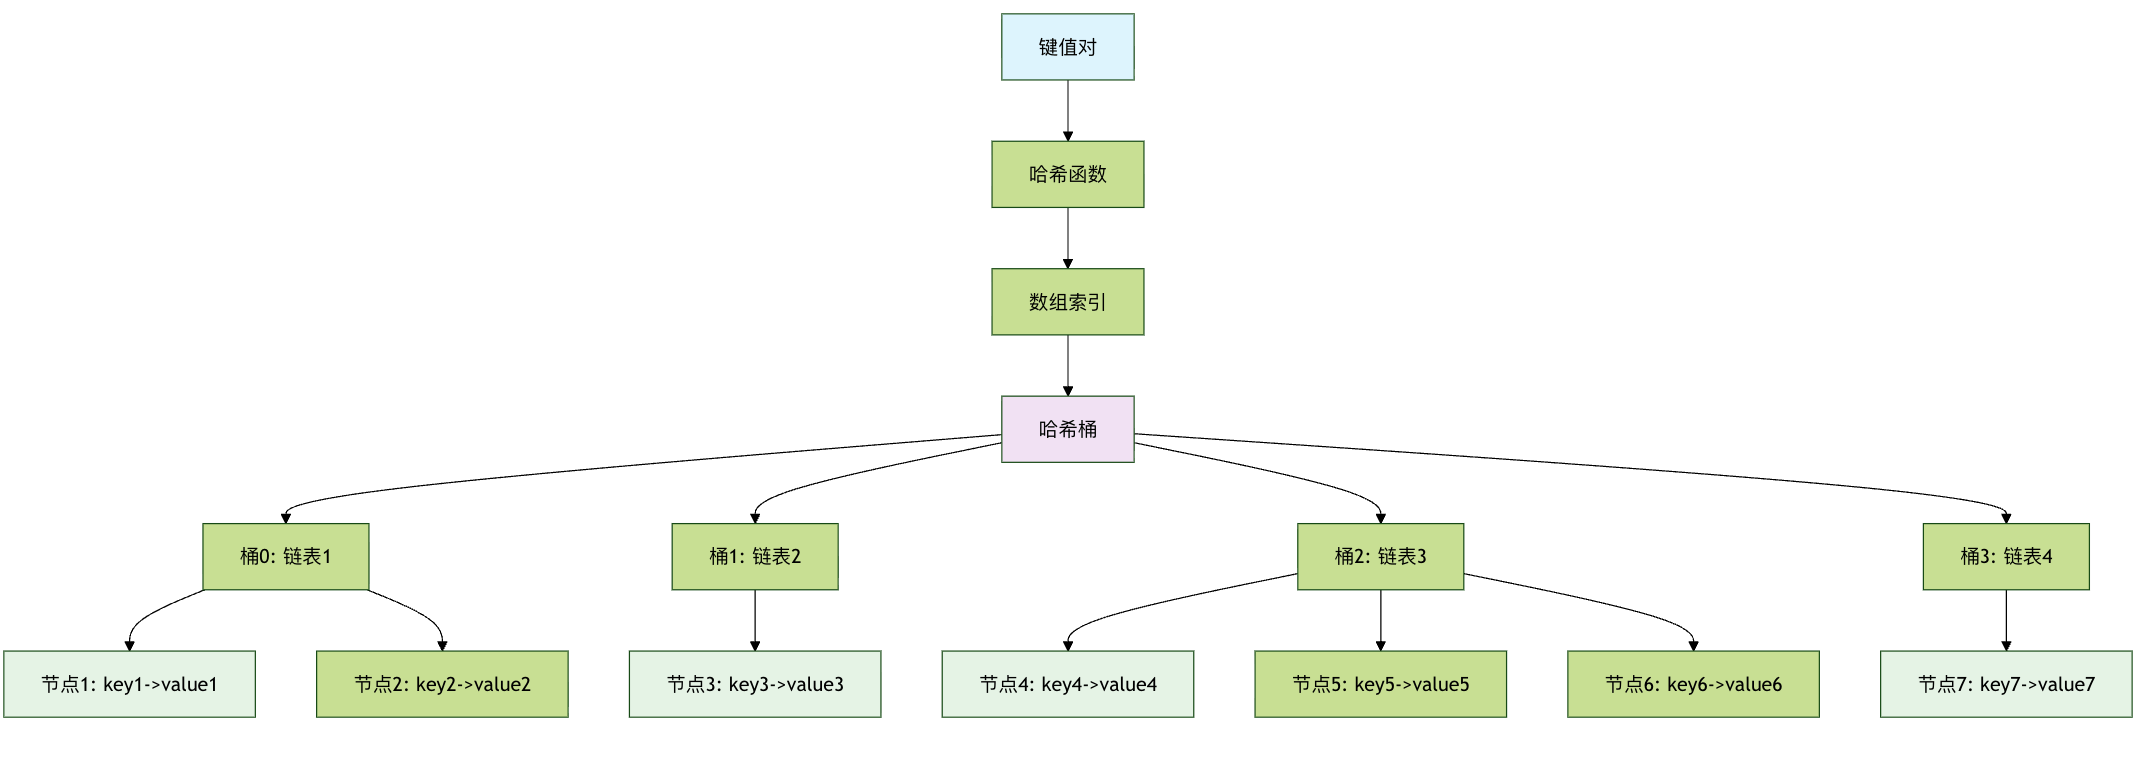
插入一条数据的完整流程是:
- 用哈希函数计算键的索引,定位到对应的桶。
- 如果桶为空,直接把键值对存入。
- 如果桶不为空(发生冲突),遍历链表:键已存在则更新值,不存在则追加到链表末尾。
实例
"""使用链地址法解决冲突的哈希表实现。"""
def __init__(self, size=10):
"""初始化哈希表。
:param size: 底层数组的初始大小
"""
self.size = size
# 创建一个大小为 size 的列表,每个元素是一个空列表(代表链表,也叫"桶")
self.table = [[] for _ in range(size)]
def _hash(self, key):
"""内部哈希函数:字符 ASCII 码累加后对表长取模(确定性的,便于演示)。"""
total = 0
for char in str(key):
total += ord(char)
return total % self.size
def insert(self, key, value):
"""向哈希表中插入一个键值对。"""
index = self._hash(key)
bucket = self.table[index] # 获取该索引对应的"桶"(链表)
# 遍历桶,检查键是否已存在
for i, (k, v) in enumerate(bucket):
if k == key:
# 键已存在,更新值
bucket[i] = (key, value)
return
# 键不存在,添加到链表末尾
bucket.append((key, value))
def get(self, key):
"""根据键获取值。如果键不存在则返回 None。"""
index = self._hash(key)
bucket = self.table[index]
for k, v in bucket:
if k == key:
return v
return None # 键不存在
def delete(self, key):
"""根据键删除键值对。"""
index = self._hash(key)
bucket = self.table[index]
for i, (k, v) in enumerate(bucket):
if k == key:
del bucket[i] # 从链表中删除该条目
return True # 删除成功
return False # 键不存在,删除失败
def display(self):
"""打印哈希表的所有内容。"""
for i, bucket in enumerate(self.table):
print(f"索引 {i}: {bucket}")
# 使用示例
print("--- 链地址法哈希表示例 ---")
phone_book = HashTableChaining(5)
phone_book.insert("Alice", "123-4567")
phone_book.insert("Bob", "987-6543")
phone_book.insert("Charlie", "555-1234")
# "David" 与 "Alice" 的哈希索引都是 3,发生冲突
phone_book.insert("David", "111-2222")
print("插入数据后的哈希表:")
phone_book.display()
print(f"\n查找 'Bob' 的电话: {phone_book.get('Bob')}")
print(f"查找不存在的 'Eve': {phone_book.get('Eve')}")
phone_book.delete("Charlie")
print("\n删除 'Charlie' 后的哈希表:")
phone_book.display()
输出结果:
--- 链地址法哈希表示例 ---
插入数据后的哈希表:
索引 0: [('Bob', '987-6543')]
索引 1: [('Charlie', '555-1234')]
索引 2: []
索引 3: [('Alice', '123-4567'), ('David', '111-2222')]
索引 4: []

查找 'Bob' 的电话: 987-6543
查找不存在的 'Eve': None

删除 'Charlie' 后的哈希表:
索引 0: [('Bob', '987-6543')]
索引 1: []
索引 2: []
索引 3: [('Alice', '123-4567'), ('David', '111-2222')]
索引 4: []
注意看索引 3:由于表长只有 5,Alice 和 David 冲突,两个键值对被链接在同一个桶里。
查找时先算出索引 3,再在链表内逐个比对键,就能找到正确的值。
工程实践: 当链表过长时,Java 的
HashMap会把链表转换为红黑树,把最坏查找时间从O(k)降到O(log k)。
开放地址法
这种方法把所有元素都存储在数组本身中,不引入额外的链表。
发生冲突时,它按照某种探测序列(Probing Sequence)在数组中寻找下一个空闲位置。
| 类型 | 探测序列 | 优点 | 缺点 |
|---|---|---|---|
| 线性探测 | h, h+1, h+2, ... |
简单易实现,对缓存友好 | 容易聚集 |
| 二次探测 | h, h+1², h+2², ... |
减少聚集 | 可能无法探测所有位置 |
| 双重哈希 | h, h+hash2(key), h+2*hash2(key), ... |
分布均匀 | 计算复杂 |
这里我们实现最简单的线性探测:
实例
"""使用线性探测开放地址法解决冲突的哈希表实现。"""
def __init__(self, size=10):
self.size = size
# 用 None 表示空位;为简化演示,暂不处理"删除"标记问题
self.keys = [None] * size
self.values = [None] * size
def _hash(self, key):
"""内部哈希函数:字符 ASCII 码累加后对表长取模。"""
total = 0
for char in str(key):
total += ord(char)
return total % self.size
def insert(self, key, value):
index = self._hash(key)
original_index = index
# 线性探测:寻找空位或相同的键
while self.keys[index] is not None:
if self.keys[index] == key:
# 键已存在,更新值
self.values[index] = value
return
index = (index + 1) % self.size # 移动到下一个位置(循环数组)
if index == original_index:
# 已经绕了一圈,表满了(实际应用中应该先扩容)
raise Exception("哈希表已满")
# 找到空位,插入
self.keys[index] = key
self.values[index] = value
def get(self, key):
index = self._hash(key)
original_index = index
# 沿着与插入相同的探测序列查找
while self.keys[index] is not None:
if self.keys[index] == key:
return self.values[index]
index = (index + 1) % self.size
if index == original_index:
break # 找了一圈没找到
return None
def display(self):
for i in range(self.size):
if self.keys[i] is not None:
print(f"索引 {i}: 键={self.keys[i]}, 值={self.values[i]}")
else:
print(f"索引 {i}: 空")
# 使用示例
print("--- 线性探测哈希表示例 ---")
ht_linear = HashTableLinearProbing(7) # 用小尺寸容易看到探测过程
# 各键的初始索引:Apple->1, Banana->3, runoob->3, Cherry->5
ht_linear.insert("Apple", 10)
ht_linear.insert("Banana", 20)
# "runoob" 与 "Banana" 冲突(索引都是 3),向后探测到 4 存入
ht_linear.insert("runoob", 30)
ht_linear.insert("Cherry", 40)
print("插入数据后的哈希表:")
ht_linear.display()
print(f"\n查找 'Banana': {ht_linear.get('Banana')}")
print(f"查找 'runoob' (冲突后探测存储的): {ht_linear.get('runoob')}")
输出结果:
--- 线性探测哈希表示例 ---
插入数据后的哈希表:
索引 0: 空
索引 1: 键=Apple, 值=10
索引 2: 空
索引 3: 键=Banana, 值=20
索引 4: 键=runoob, 值=30
索引 5: 键=Cherry, 值=40
索引 6: 空
runoob 的初始索引是 3,但该位置已被 Banana 占用。
线性探测向后移动一格,最终把它存到了索引 4,查找时沿着同样的路径就能找到它。
注意: 开放地址法的删除比较麻烦,不能简单把位置置回
None,否则会打断探测序列,导致后面的元素查不到。通常做法是放一个特殊的"已删除"标记(惰性删除),查找时跳过它,插入时可以复用。本例为简化未实现删除。
两种方法对比
两种方法各有取舍,实际选型时可参考下表:
| 特性 | 链地址法 | 开放地址法 |
|---|---|---|
| 实现难度 | 相对简单 | 相对复杂,尤其是删除操作 |
| 空间开销 | 需要额外空间存储指针(链表) | 所有数据都在数组中,空间利用率可能更高 |
| 冲突影响 | 冲突只影响同一个桶(链表)的性能 | 冲突会挤占后续位置,可能导致"聚集"现象 |
| 扩容时机 | 当平均链表长度超过阈值时扩容 | 当负载因子(元素数/数组大小)超过阈值时扩容 |
| 适用场景 | 通用,更常见 | 对缓存友好,适用于已知最大数据量或内存紧张的场景 |
性能与负载因子
哈希表的效率高度依赖一个关键指标:负载因子(Load Factor)。
负载因子 = 哈希表中已存储的元素数量 ÷ 哈希表数组的总大小。
| 负载因子 | 含义 | 对性能的影响 |
|---|---|---|
| 低(如 0.5) | 数组还有大量空位 | 冲突概率小,操作速度快 |
| 高(如 0.9) | 数组接近满载 | 链表变长或探测距离变长,性能明显下降 |
为了保持高性能,当负载因子超过某个阈值(例如 0.75)时,哈希表会进行扩容:
- 创建一个新的、更大的数组(通常是原大小的两倍)。
- 遍历旧哈希表中的所有键值对。
- 根据新的数组大小重新计算每个键的索引,并插入到新数组中。
这个过程称为 Rehashing。
虽然单次扩容比较耗时,但它能显著降低负载因子,让哈希表恢复高效。
由于扩容是均摊到多次插入操作中的,哈希表的插入平均复杂度依然是 O(1)。
实践练习:构建一个单词计数器
让我们用自制的链地址法哈希表解决一个实际问题:统计一段文本中每个单词出现的次数。
测试文本如下:
the quick brown fox jumps over the lazy dog i learn python on runoob and runoob is free
实例
print("=== 实践练习:单词计数器 ===")
# 1. 创建哈希表实例
word_counter = HashTableChaining(size=10)
# 2. 提供的测试文本
text = "the quick brown fox jumps over the lazy dog i learn python on runoob and runoob is free"
words = text.split() # 将文本分割成单词列表
print("处理的单词列表:", words)
# 3. 遍历单词,插入哈希表
for word in words:
current_count = word_counter.get(word)
if current_count is None:
# 单词第一次出现,计数为 1
word_counter.insert(word, 1)
else:
# 单词已存在,计数加 1
word_counter.insert(word, current_count + 1)
# 4. 输出统计结果
# display() 会按索引打印,这里合并所有桶,输出更友好的结果
print("\n单词出现次数统计:")
all_entries = []
for bucket in word_counter.table:
all_entries.extend(bucket) # 将所有桶中的条目合并
for word, count in all_entries:
print(f" '{word}': {count} 次")
# 5. 验证特定单词
test_word = "the"
print(f"\n验证:单词 '{test_word}' 出现了 {word_counter.get(test_word)} 次。")
test_word = "runoob"
print(f"验证:单词 '{test_word}' 出现了 {word_counter.get(test_word)} 次。")
输出结果:
=== 实践练习:单词计数器 ===
处理的单词列表: ['the', 'quick', 'brown', 'fox', 'jumps', 'over', 'the', 'lazy', 'dog', 'i', 'learn', 'python', 'on', 'runoob', 'and', 'runoob', 'is', 'free']

单词出现次数统计:
  'learn': 1 次
  'is': 1 次
  'the': 2 次
  'quick': 1 次
  'on': 1 次
  'runoob': 2 次
  'brown': 1 次
  'fox': 1 次
  'over': 1 次
  'dog': 1 次
  'python': 1 次
  'i': 1 次
  'and': 1 次
  'lazy': 1 次
  'free': 1 次
  'jumps': 1 次

验证:单词 'the' 出现了 2 次。
验证:单词 'runoob' 出现了 2 次。
你已经成功用自己实现的哈希表完成了一个实用任务。
在真实开发中,你几乎不需要手写哈希表,因为现代编程语言都提供了高度优化的内置实现,比如 Python 的 dict、Java 的 HashMap、C++ 的 unordered_map。
理解其原理,能帮助你更明智、更高效地使用它们。
总结与要点回顾
最后用一张表梳理本文的核心知识点:
| 要点 | 说明 |
|---|---|
| 哈希表是什么 | 通过键直接访问值的高效数据结构,平均时间复杂度 O(1) |
| 核心机制 | 哈希函数把键转换为数组索引 |
| 关键挑战 | 哈希冲突:不同的键映射到同一索引,且不可避免 |
| 解决方案一 | 链地址法:每个索引位置挂一个链表,存储冲突的键值对 |
| 解决方案二 | 开放地址法:在数组内按探测序列寻找下一个空位 |
| 性能关键 | 负载因子过高时,通过扩容和重哈希恢复性能 |
| 实际应用 | 数据库索引、缓存系统、集合成员检查、对象属性存储等 |